ClovisLLM - GLM 5.3

ClovisLLM évoluera prochainement vers GLM 5.3, qui remplacera GLM 5.2. Découvrez les progrès de cette nouvelle version à travers un comparatif des performances des deux modèles et des principales alternatives du marché.
La migration de ClovisLLM vers GLM 5.3 aura lieu le 2 novembre 2026.
GLM 5.3 conserve le modèle de base de GLM 5.2 ; ses gains proviennent du post-entraînement, selon la fiche officielle de Z.ai.
Les chiffres à retenir
Source : fiche officielle GLM 5.3 — benchmarks et protocoles. Ces résultats sont publiés par l’éditeur, et ne constituent pas des mesures réalisées sur Clovis.
Comparaison avec les autres modèles du marché
Ce graphique compare GLM 5.3 et GLM 5.2 à Kimi K3, Fable 5 et GPT-5.6 Sol sur six benchmarks.
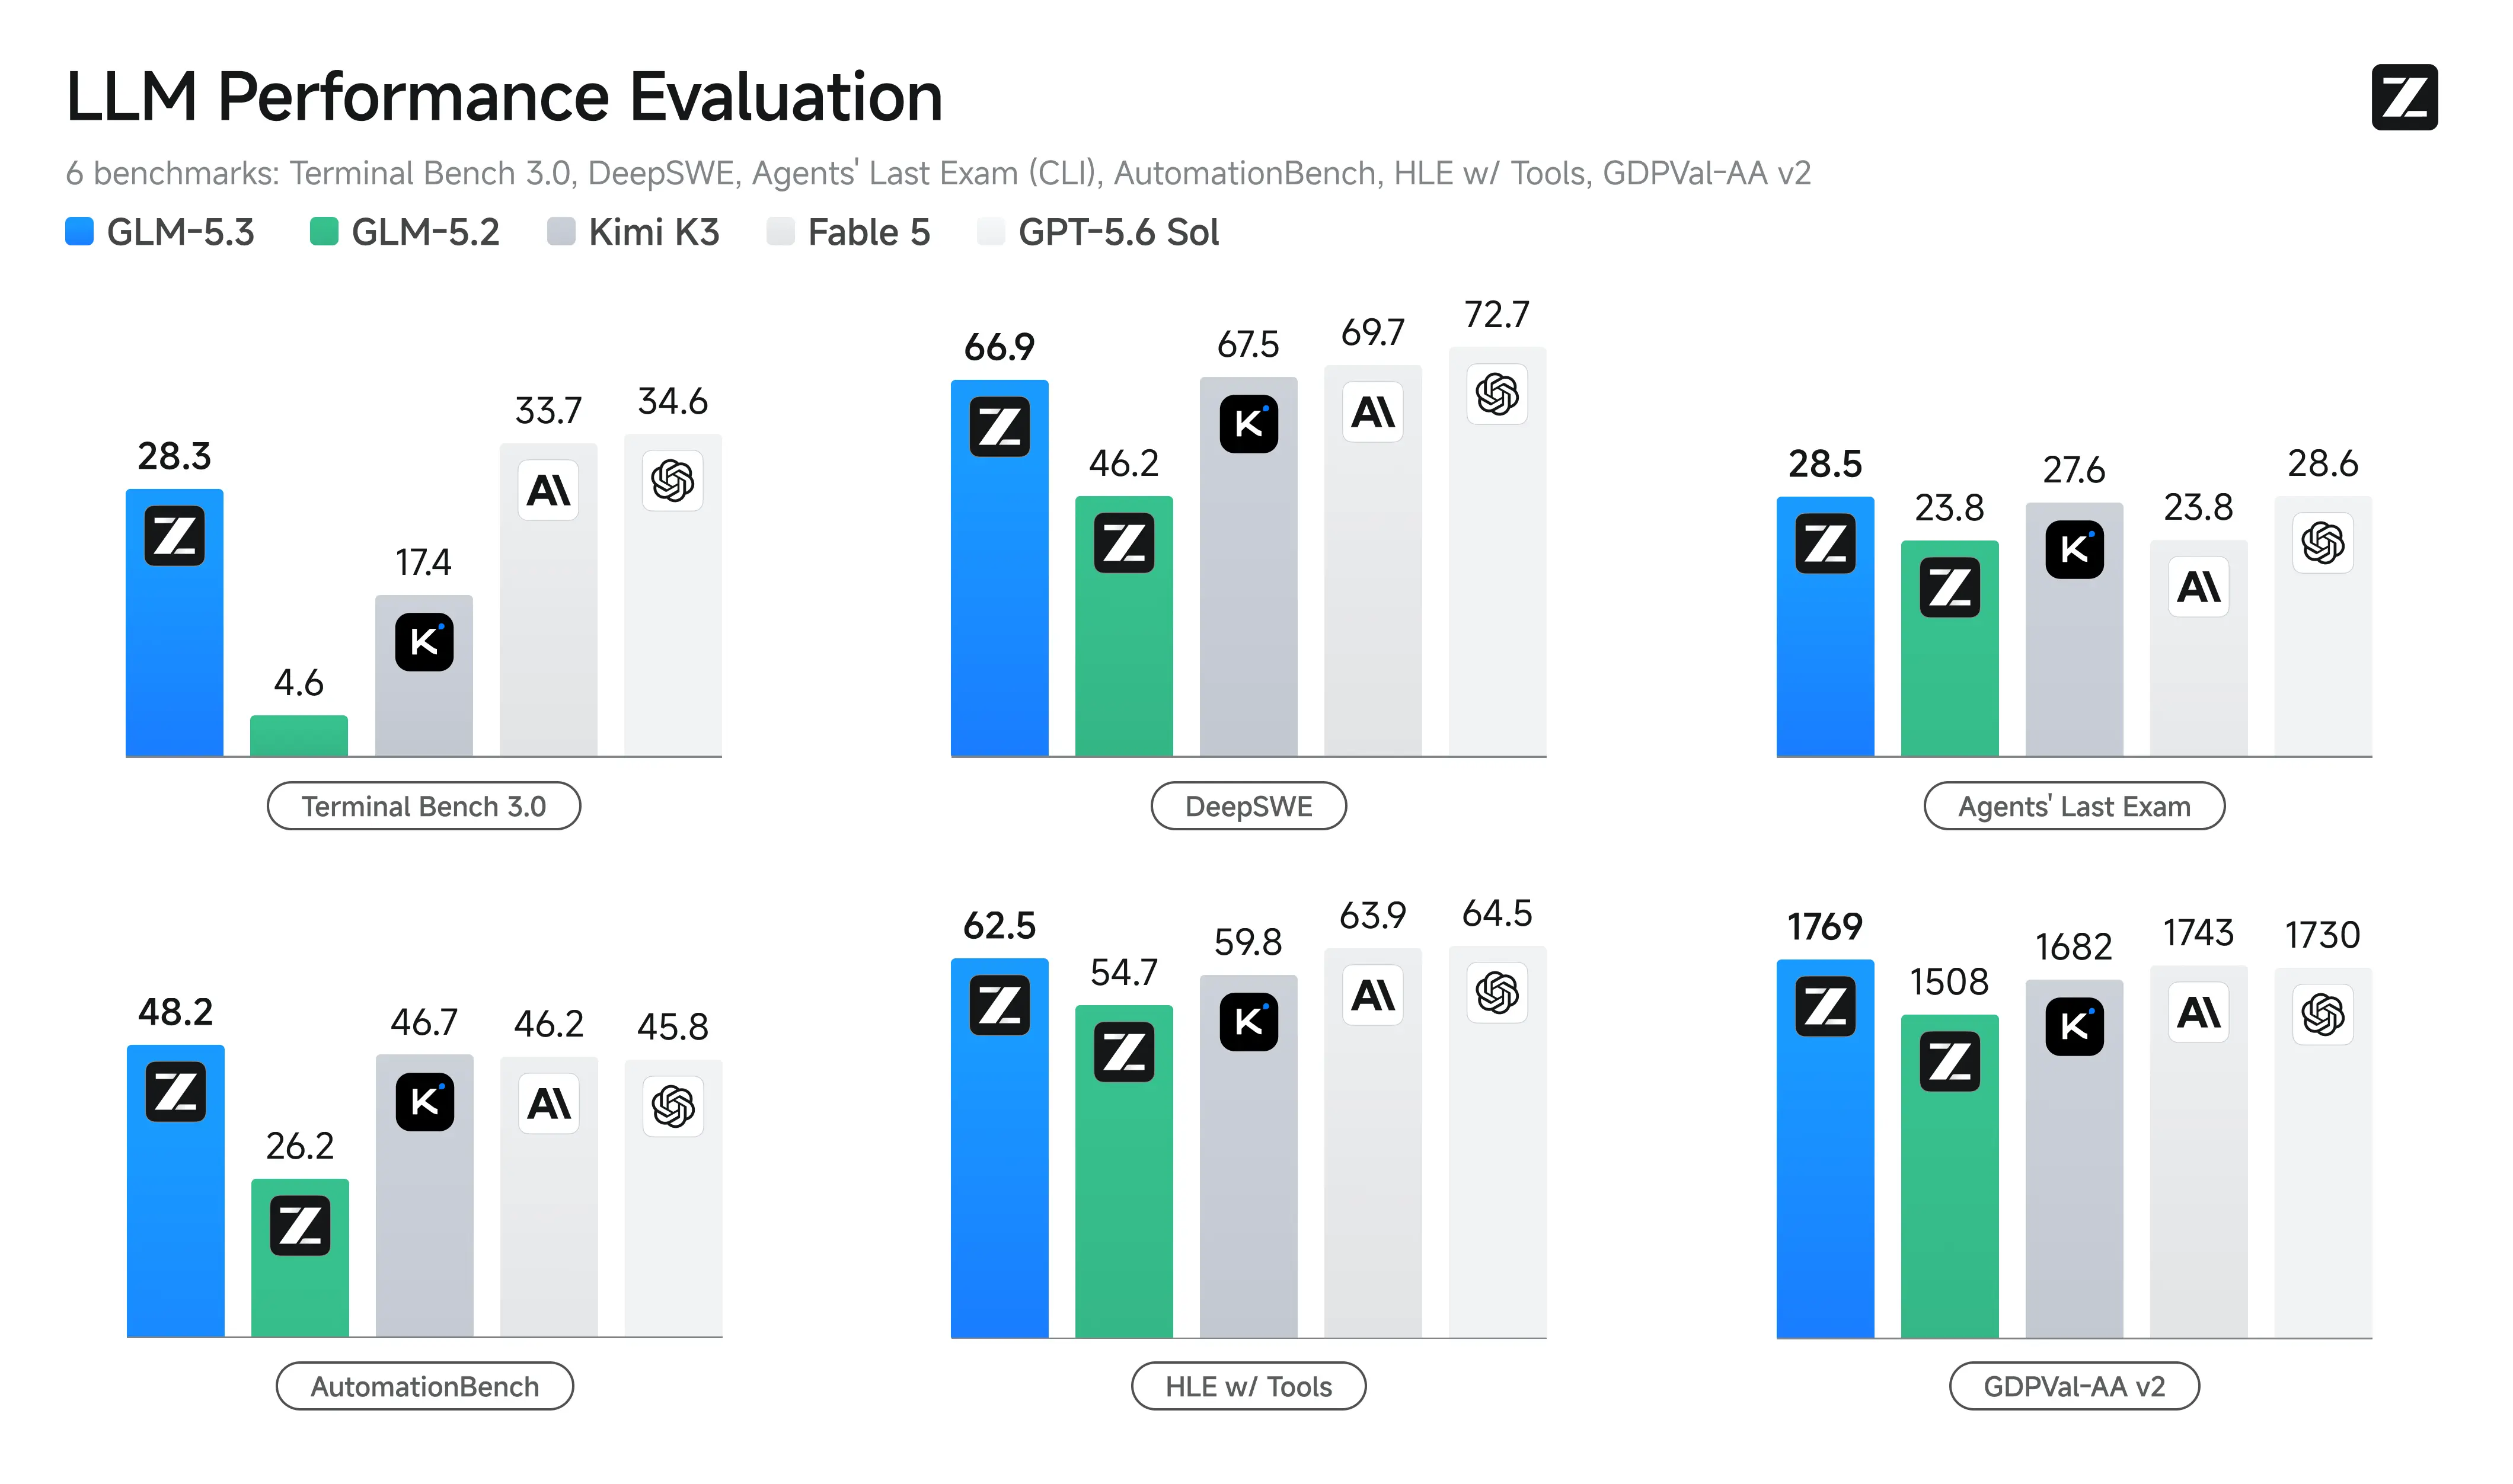
Source : comparatif officiel GLM 5.3 de Z.ai.
Un modèle plus solide pour le développement et les agents
Avec GLM 5.3, les progrès concernent surtout les tâches qui demandent de travailler sur un projet dans la durée. DeepSWE passe de 46,2 à 66,9, et SWE-Marathon de 19,4 à 42,5. Ces résultats suggèrent une meilleure capacité à mener une évolution logicielle jusqu’à son terme : comprendre le code existant, modifier les fichiers concernés, exécuter les tests et corriger les erreurs rencontrées.
L’autre évolution concerne les agents qui utilisent des outils. Avec 73,0 sur Toolathlon Verified et 48,2 sur AutomationBench, GLM 5.3 progresse sur l’exécution de tâches qui combinent plusieurs actions. Pour ClovisLLM, l’intérêt attendu est de mieux accompagner les workflows où le modèle doit consulter des informations, agir à partir de ces informations et poursuivre le travail avec les résultats obtenus.